

Multi-Token Prediction: la nuova sfida per la Pubblica Amministrazione tra ottimizzazione, resilienza e controllo dello stato interno
Non è certo una novità che le Pubbliche Amministrazioni facciano affidamento, in misura sempre più crescente, sui modelli avanzati di IA. Secondo il report del CERT-AgID (Computer Emergency Response Team dell’Agenzia per l’Italia Digitale) del giugno 2026, una nuova tecnologia emergente che permetterebbe di ridurre i tempi di risposta, il Multi-Token Prediction (MTP), potrebbe configurare un rischio per la sicurezza e la stabilità dei servizi della Pubblica Amministrazione. Vengono in soccorso a riguardo le bozze di linee guida AgID, le quali affrontano lo sviluppo dell’IA lungo l’intero ciclo di vita e lo collegano alle scelte di procurement, ponderando l’adozione di queste nuove tecnologie.
Sommario. 1. La svolta del MTP nel mondo dei Large Language Model: dal “Next-Token” al “Multi-Token” Prediction. – 2. L’inferenza e i rischi operativi: il Report CERT-AgID. – 3. I principi delle bozze di Linee Guida AgID. – 4. Gestione del rischio: i costi sono prevedibili? – 5. Il quadro normativo.
1. La svolta del MTP nel mondo dei Large Language Model: dal “Next-Token” al “Multi-Token” Prediction
Tradizionalmente l’addestramento dei modelli linguistici si basava sul next-token prediction: si insegnava all’intelligenza linguistica a indovinare la parola immediatamente successiva. Infatti nel decoding autoregressivo il modello normalmente produceva un token alla volta. Sebbene le implementazioni moderne utilizzino la KV cache, ossia una tecnica di ottimizzazione della memoria usata dai modelli di linguaggio basati su trasformatori, per evitare di calcolare integralmente le rappresentazioni precedenti, la generazione resta vincolata, data la natura sequenziale del processo.
Nel contesto dei LLM un token è l’unità fondamentale di testo in cui il sistema scompone le parole per poterle leggere, elaborare e generare. Non necessariamente un token corrisponde a una parola intera; ciò infatti dipende da come è addestrato il tokenizer del modello. Ciascun token viene tradotto in un codice numerico univoco che la rete neurale elabora matematicamente. Più precisamente il tokenizer associa una sequenza di caratteri a token, ai quali corrispondono ID numerici. Questi ID a loro volta vengono trasformati in rappresentazioni vettoriali. La capacità di un LLM di ricordare i messaggi precedenti viene misurata sempre in token. Nelle lingue occidentali possiamo dire che 100 token corrispondano a circa 75 parole (tipicamente per l’inglese, lo stesso documento in italiano richiede più token, quindi costa di più). Con l’MTP vediamo che il modello durante la generazione usa e gestisce questi token diversamente.
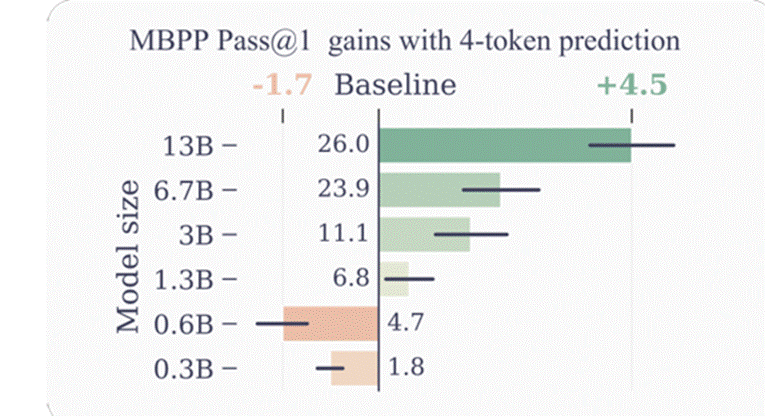
Compreso questo limite, nel 2024 un team di ricercatori di FAIR (Facebook AI Research, il laboratorio di ricerca sull’AI di Meta) sistematizza e porta su larga scala questa tecnologia. Il team pubblicò un paper intitolato “Better & Faster Large Language Models via Multi-Token Prediction”. I ricercatori compresero che addestrare il modello a indovinare solo il token immediatamente successivo lo affaticava nel pianificare la struttura a lungo termine di un testo. Meta ha affermato che i suoi modelli hanno ottenuto prestazioni migliori del 17% su MBPP e del 12% su HumanEval (benchmark usati per misurare le capacità di programmazione e di ragionamento dei modelli di IA) rispetto ai LLM comparabili che generano token uno alla volta; inoltre, i modelli hanno generato output tre volte più velocemente. In realtà, come rappresentato nella Tabella 2, un tale miglioramento è relativo esclusivamente ai modelli 13B; al contrario, in modelli piccoli (0.3B e 0.6B) il delta è negativo, e dunque si può affermare che in modelli a basso numero di parametri l’uso di MTP peggiori le prestazioni.
“Durante l’addestramento, il modello predice quattro token futuri contemporaneamente, per mezzo di un tronco condiviso e quattro teste di output dedicate. Durante l’inferenza, impieghiamo solo la testa di output del token successivo. Facoltativamente, le altre tre teste possono essere utilizzate per accelerare i tempi di inferenza. (In basso) La predizione multi-token migliora la metrica pass@1 sul task di programmazione MBPP, in modo significativo all’aumentare delle dimensioni del modello. Le barre d’errore sono intervalli di confidenza al 90% calcolati mediante bootstrapping sui campioni del dataset.” (Gloeckle et al., 2024)
La metrica pass@1 misura la probabilità che un singolo output sia stato generato correttamente da un modello di intelligenza artificiale al primo tentativo.
Grafico 1
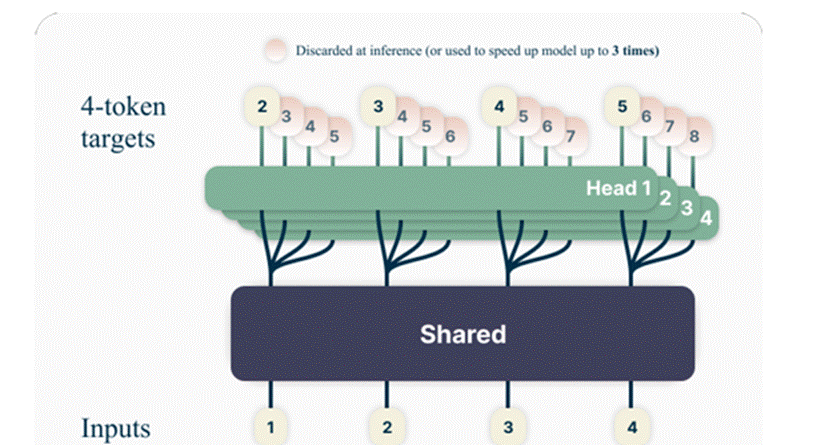
Grafico 2
Attualmente DeepSeek-V3 adotta un obiettivo MTP nel proprio addestramento, ma si distingue da Meta per una implementazione diversa rispetto a quella originale: infatti mentre Gloeckle et al. predicono i token futuri in parallelo con teste indipendenti, invece DeepSeek-V3 li predice in sequenza, mantenendo la catena causale completa ad ogni livello di profondità. Come affermato nel loro Technical Report, nella sezione 2.2 Multi-Token Prediction:
“Ispirandoci a Gloeckle et al. (2024), abbiamo studiato e adottato un obiettivo di Multi-Token Prediction (MTP) per DeepSeek-V3, che estende l’ambito della predizione a più token futuri per ciascuna posizione. Da un lato, un obiettivo MTP densifica i segnali di addestramento e può migliorare l’efficienza nell’uso dei dati. Dall’altro, l’MTP può consentire al modello di pianificare in anticipo le proprie rappresentazioni interne, per predire meglio i token futuri. La Figura 3 illustra la nostra implementazione dell’MTP. A differenza di Gloeckle et al. (2024), che predicono in parallelo D token aggiuntivi utilizzando teste di output indipendenti, noi prediciamo i token aggiuntivi in sequenza, mantenendo la catena causale completa a ogni profondità di predizione. In questa sezione presentiamo i dettagli della nostra implementazione dell’MTP.”
2. L’inferenza e i rischi operativi: il Report CERT-AgID
In fase di inferenza (dopo l’apprendimento), l’MTP viene spesso associato al decoding speculativo: il draft model (il modello secondario più leggero) indovina velocemente in anticipo i successivi token, mentre il target model (il modello principale che controlla) prende la bozza creata dal draft e la verifica con un solo passaggio di calcolo. Infatti, mentre l’MTP ha la capacità di predire molteplici token, il decoding speculativo definisce invece il meccanismo di verifica ed accettazione.
Nei LLM tradizionali il limite di velocità è dato dalla potenza di calcolo della scheda video e soprattutto dalla velocità con cui la memoria sposta i dati da un chip all’altro per calcolare i token. Ed è in questa fase di inferenza che subentra l’analisi del CERT-AgID: il draft propone ma deve essere il target a decidere. Il draft non deve mai diventare l’autorità finale. Cosa succederebbe se così fosse? Non accelererebbe solo il processo, ma andrebbe a modificare le decisioni del modello principale, incidendo nei casi più gravi anche sulla verificabilità del processo decisionale.
Il report del CERT-AgID si basa principalmente su uno scenario critico dal punto di vista della gestione dello stato, che si può verificare durante l’inferenza. Non si tratta di una anomalia ma di uno scenario fisiologico.
- La parziale accettazione: il draft propone tre token e, invece di accettarli tutti e tre (full accept) o rifiutarli tutti e tre (full reject), il target ne accetta solo una parte (partial accept). Cosa accadrebbe in questo caso? Il sistema dovrebbe integrare la parte corretta, scartare quella errata e riallineare lo stato interno per ripartire dal punto esatto. Qui nasce una complicazione: nel percorso MTP è necessario tenere coerenti tra loro e sincronizzati sia lo stato interno del modello target sia quello del modello draft. Nel runtime questo disallineamento si presenta quando non restano coerenti vari elementi: la KV cache, il frontier logico, il sampler, token accettati e rifiutati. Infatti il punto di generazione ufficiale può trovarsi temporaneamente più avanti dello stato consolidato. La KV cache, già citata precedentemente, è una memoria interna del transformer e si comporta come un segnalibro del punto raggiunto. Il disallineamento avviene quando tale segnalibro ed il testo consolidato non indicano lo stesso punto.
Il rischio per la sicurezza si verifica quando il runtime considera i token proposti come se fossero già stati verificati. Dall’analisi condotta dalla CERT-AgID, quando il percorso dell’MTP non è stabile, si attivano due meccanismi di recupero:
- Il replay: per cui il sistema deve rifare una parte del lavoro precedentemente svolto;
- Il fallback: per cui il runtime scarta il decoding speculativo più veloce e torna al decoding classico.
Se questi due meccanismi risultano frequenti, la disponibilità peggiorerà. È importante chiedersi cosa succede quando il draft model sbaglia spesso. Il costo computazionale resta controllato anche quando i prompt sono difficili? Infatti, un prompt difficile potrebbe portare il draft a sbagliare più spesso, e il costo computazionale crescerebbe rispetto al caso normale.
Come è stato anticipato precedentemente, il draft model non deve essere l’autorità finale, ma deve generare delle ipotesi che il target model andrà a convalidare. Per rendere il comportamento più stabile, più misurabile e facile da verificare, il draft model deve scegliere le proposte più prevedibili, invece di spingere il target a intraprendere traiettorie più delicate e pericolose. Il rischio è nelle implementazioni di runtime che perdono il controllo dello stato interno.
3. I principi delle bozze di Linee Guida AgID
Il report della CERT-AgID conclude la propria analisi con le seguenti domande:
“Il criterio finale di scelta non può essere solo: è più veloce? Deve essere anche:
• è ancora controllato?
• è verificabile?
• mantiene il target come arbitro finale?
• resta stabile con input difficili?
• ha costi prevedibili?”
A tal proposito, le domande con cui si chiude il report possono essere lette alla luce dei principi contenuti nelle bozze di linee guida AgID per lo sviluppo e per il procurement. I due documenti si pongono infatti in un rapporto di complementarità: da una parte il report della CERT-AgID individua sul piano tecnico i criteri e le metriche con cui valutare un runtime MTP, dall’altra le bozze di linee guida forniscono i principi e gli strumenti contrattuali con cui la PA può esigerli in fase di sviluppo e di gara. Di seguito si propone una lettura che ricollega ciascuno criterio del report al principio corrispondente.
Il Piano Triennale per l’Informatica nella Pubblica Amministrazione 2024-2026 ha introdotto un quadro specifico dedicato all’Intelligenza Artificiale, individuando l’aumento della consapevolezza delle Pubbliche Amministrazioni nell’adozione delle tecnologie di IA e prevedendo la definizione di linee guida per promuoverne l’adozione. Tale attività si inserisce nelle competenze dell’ AgID e nell’iter previsto dall’articolo 71 del Codice dell’Amministrazione Digitale (CAD).
AgID, con la Determinazione n. 17 del 17 febbraio 2025, ha avviato l’iter di consultazione delle Linee guida per l’adozione dell’Intelligenza Artificiale nella Pubblica Amministrazione. Successivamente, con la Determinazione n. 43 del 10 marzo 2026, è stato avviato l’iter di consultazione delle Linee guida per lo sviluppo e delle Linee guida per il procurement dell’Intelligenza Artificiale nella Pubblica Amministrazione.
Questo approccio basato sullo stack tecnologico dell’IA consente alla Pubblica Amministrazione di effettuare scelte consapevoli e controllabili, preservando l’autonomia decisionale e operativa nel tempo.
Vengono individuati 20 principi per l’adozione, lo sviluppo e il procurement dei sistemi di IA.
Nel report della CERT-AgID si parla di:
- Non opacità: può essere ricollegato al settimo principio (“Trasparenza, spiegabilità e documentazione”): “I sistemi devono essere sviluppati con meccanismi di spiegabilità proporzionati al rischio e al contesto d’uso. Le architetture devono consentire la documentazione separata e aggiornata di modelli, agenti, servizi e logiche di orchestrazione, favorendo la tracciabilità delle decisioni“. “Il procurement deve garantire accesso continuativo alla documentazione tecnica e funzionale, anche post-contratto mediante apposite clausole in fase di gara. I contratti devono prevedere obblighi di aggiornamento della documentazione in caso di modifica dei modelli, degli agenti o delle logiche decisionali”.
È citabile anche il quattordicesimo principio (“Registrazioni – logging”): “I sistemi devono essere sviluppati con meccanismi di logging interoperabili, strutturati e verificabili mediante audit, che traccino decisioni, flussi di dati, interventi umani e interazioni tra agenti. I log devono essere indipendenti dall’infrastruttura sottostante e conservabili anche in caso di migrazione o dismissione“. “I contratti devono garantire alla PA accesso completo ai log, diritti di audit e possibilità di esportazione in formati aperti. Il procurement deve evitare soluzioni che rendano i log non accessibili o vincolati a piattaforme proprietarie”.
- Verificabile: possiamo ricollegarlo al decimo principio (“Accuratezza”): “Lo sviluppo deve prevedere metriche di accuratezza misurabili, documentate e monitorabili nel tempo, in relazione al contesto d’uso e al livello di rischio. I sistemi devono consentire l’aggiornamento o la sostituzione dei modelli (anche tramite orchestrazione agentica) in caso di degrado delle prestazioni”. “I contratti devono includere SLA e KPI sull’accuratezza, con meccanismi di intervento correttivo inclusa la sostituzione progressiva dei modelli. Il procurement deve evitare vincoli che impediscano l’adeguamento delle prestazioni nel tempo”.
Questo decimo principio richiede SLA e KPI misurabili, e il report del CERT-AgID fornisce esattamente l’elenco delle metriche che una Pubblica Amministrazione può mettere a contratto: acceptance rate, frequenza di replay e fallback, p95 di latenza, comportamento sotto prompt difficili. Infatti l’analisi non si ferma alla latenza media ma misura anche la coda, calcolando i percentili p75 e p95.
- Controllato dal target: tredicesimo principio (“Sorveglianza umana”): “I sistemi devono consentire un intervento umano effettivo, tempestivo e documentabile, anche a livello di orchestrazione dei servizi e degli agenti di IA. Lo sviluppo deve prevedere punti di controllo, modalità di override e meccanismi di arresto o riconfigurazione del sistema”. “Il procurement deve escludere soluzioni che impediscano il controllo umano sostanziale o che rendano l’intervento umano solo formale. I contratti devono garantire accesso operativo agli strumenti di supervisione, senza dipendenze esclusive dal fornitore”.
- Robusto nei casi peggiori: undicesimo principio (“Robustezza”): “I sistemi devono essere progettati con architetture modulari, resilienti e degradabili, in grado di mantenere livelli di servizio proporzionati anche in condizioni non ottimali. Lo sviluppo deve prevedere meccanismi di fallback, inclusa l’esecuzione su infrastrutture CPU-only, architetture hardware-agnostic e la riallocazione dinamica dei componenti tramite orchestrazione“. “Il procurement deve favorire soluzioni componibili e sostituibili, riducendo il rischio di lock-in tecnologico. I contratti devono prevedere clausole di verifica ed eventualmente risoluzione contrattuale in caso di comportamenti non in linea con quanto previsto a livello contrattuale”.
4. Gestione del rischio: i costi sono prevedibili?
Arrivati a questo punto, possiamo appunto citare il terzo principio (“La gestione del rischio”) presente nelle bozze di linee guida sul procurement. Infatti nello sviluppo e nel procurement, la PA deve condurre un’analisi approfondita dei rischi non solo sotto il punto di vista dei profili tecnologici e organizzativi, ma valutando anche il rischio economico. Quindi in questo caso dove si configura il rischio? Come descritto nel report CERT-AgID un prompt difficile potrebbe portare il draft a sbagliare più spesso. E nel Path MTP il costo dipende da quanto il draft riesce ad anticipare bene il target. Nel caso dunque di un prompt difficile ci sarebbero rifiuti, molteplici partial accept, più riallineamenti dello stato interno e più replay. Il rischio è la crescita abnormale del costo computazionale. Per cui se l’input viene costruito con l’obiettivo di spingere il sistema verso questi casi costosi si potrebbe andare a creare una forma di Denial of Service applicativo: il sistema funziona ma viene portato a fare più lavoro. Se il costo computazionale restasse controllato anche nei prompt difficili allora l’MTP sarebbe più sicuro da usare, tenendo anche in considerazione l’integrità del comportamento e la disponibilità.
Per comprendere al meglio tale rischio economico dobbiamo analizzare come vengono valutati i sistemi di IA. Infatti, le pratiche tradizionali si fondano su indicatori parziali: il costo per token, il costo per chiamata API, la fatturazione per ora di calcolo o, in alcuni casi, il Total Cost of Ownership (TCO). Ma questi indicatori non permettono di rappresentare in modo completo l’impatto economico dell’IA. Data la diffusione sempre più crescente di modelli di servizio basati sul consumo, questi indicatori appaiono insufficienti per prevedere i costi. Come viene detto nella bozza di linee guida riguardante il procurement, “le pubbliche amministrazioni dovrebbero adottare un approccio di valutazione economica fondato sull’analisi di ciclo di vita dei sistemi di IA. Tale approccio consente di rappresentare in modo unitario i costi di investimento e quelli di esercizio, nonché di valutare la sostenibilità complessiva della soluzione”. In questa prospettiva assume un rilievo interessante il concetto di Costo Livellato dell’IA (Levelized Cost of Artificial Intelligence – LCOAI), quale metrica proposta per l’analisi economica comparativa delle diverse strategie di procurement e deployment. Tale metrica, introdotta dall’economista Eliseo Curcio e riportata nello Strumento C delle bozze di linee guida sul procurement, esprime il rapporto tra il costo complessivo del ciclo di vita del sistema e l’output produttivo che viene effettivamente generato. Il livellamento implica la somma sulla vita utile e lo sconto a un tasso.
Il LCOAI somma i costi di investimento iniziale (CAPEX) e i costi operativi ricorrenti(OPEX), dividendoli per il volume complessivo delle prestazioni erogate, calcolato sugli output effettivamente validi (Q). Nel caso venisse adottato l’MTP si potrebbero presentare due tipologie di scenari, in base al modello di deployment scelto dalla Pubblica Amministrazione:
-il runtime locale: la PA acquista l’infrastruttura hardware, quindi il CAPEX è fisso e l’effetto dell’MTP ricade sull’ OPEX, dovendo considerare il carico di calcolo, i costi di manutenzione straordinaria legati all’uso intensivo delle risorse;
-as-a-service: il CAPEX è quasi nullo (la PA non dovrebbe comprare alcun server perchè l’MTP sarebbe disponibile attraverso un servizio esterno) e l’impatto è interamente sull’ OPEX variabile (riguardante il consumo di API, il monitoraggio e il loggin al servizio esterno). In questo scenario il costo dei token scartati resta al fornitore ed il rischio per la PA si sposta sulla latenza (SLA). Per questo motivo è fondamentale mettere il p95 a contratto.
L’adozione di una metrica di costo livellato permette alla PA di confrontare modelli di fornitura diversi su basi omogenee. Nel path MTP, nel caso di runtime, l’aumento dei costi di esercizio fa sì che il costo totale cresca mentre l’output valido (Q) rimane invariato, quindi il LCOAI peggiora anche se il sistema continua a rispondere correttamente.
5. Il quadro normativo
La resilienza, richiesta dall’articolo 15 del Regolamento UE 2024/1689 (AI Act) “Accuratezza, robustezza, cybersicurezza”, non si esaurisce nella capacità del sistema di evitare errori o guasti evidenti, ma comprende anche la tenuta delle sue prestazioni di fronte a input costruiti ad hoc per sfruttarne le vulnerabilità. Tale articolo non disciplina specificamente il caso del DoS applicativo, il quale presenta alcune analogie con la logica dell’adversarial example, pur distinguendosi per l’obiettivo: il DoS non mira ad ottenere un errore del modello ma a modificare il profilo computazionale dell’inferenza. Solitamente si pensa ad un input costruito per ottenere un output scorretto, in questo caso invece l’input è costruito per ottenere un output corretto ma costosissimo da produrre. Dunque, interpretando l’articolo in tal maniera, pare necessario evidenziare i paragrafi 4&5:
“4. I sistemi di IA ad alto rischio sono il più resilienti possibile per quanto riguarda errori, guasti o incongruenze che possono verificarsi all’interno del sistema o nell’ambiente in cui esso opera, in particolare a causa della loro interazione con persone fisiche o altri sistemi. A tale riguardo sono adottate misure tecniche e organizzative.
La robustezza dei sistemi di IA ad alto rischio può essere conseguita mediante soluzioni tecniche di ridondanza, che possono includere piani di backup o fail-safe.
I sistemi di IA ad alto rischio che proseguono il loro apprendimento dopo essere stati immessi sul mercato o messi in servizio sono sviluppati in modo tale da eliminare o ridurre il più possibile il rischio di output potenzialmente distorti che influenzano gli input per operazioni future (feedback loops – «circuiti di feedback») e garantire che tali circuiti di feedback siano oggetto di adeguate misure di attenuazione.
5. I sistemi di IA ad alto rischio sono resilienti ai tentativi di terzi non autorizzati di modificarne l’uso, gli output o le prestazioni sfruttando le vulnerabilità del sistema.
Le soluzioni tecniche volte a garantire la cibersicurezza dei sistemi di IA ad alto rischio sono adeguate alle circostanze e ai rischi pertinenti.
Le soluzioni tecniche finalizzate ad affrontare le vulnerabilità specifiche dell’IA includono, ove opportuno, misure volte a prevenire, accertare, rispondere, risolvere e controllare gli attacchi che cercano di manipolare il set di dati di addestramento (data poisoning – «avvelenamento dei dati») o i componenti preaddestrati utilizzati nell’addestramento (model poisoning – «avvelenamento dei modelli»), gli input progettati in modo da far sì che il modello di IA commetta un errore (adversarial examples – «esempi antagonistici», o model evasion, – «evasione dal modello»), gli attacchi alla riservatezza o i difetti del modello.”
Verso la stessa traiettoria porta l’articolo 3 della Legge 132/2025, riguardante la ricerca, la sperimentazione, lo sviluppo, l’adozione l’applicazione e l’utilizzo di sistemi e modelli di Intelligenza Artificiale per finalità generali, che al sesto comma afferma:
“Al fine di garantire il rispetto dei diritti e dei principi di cui al presente articolo deve essere assicurata, quale precondizione essenziale, la cybersicurezza lungo tutto il ciclo di vita dei sistemi e dei modelli di intelligenza artificiale per finalità generali, secondo un approccio proporzionale e basato sul rischio, nonché l’adozione di specifici controlli di sicurezza, anche al fine di assicurarne la resilienza contro tentativi di alterarne l’utilizzo, il comportamento previsto, le prestazioni o le impostazioni di sicurezza.”
La resilienza è un requisito di sicurezza, non un optional prestazionale. Per cui, in questa ottica, si comprende appieno la natura del rischio analizzato: il Denial of Service applicativo, qui discusso, sfugge alla categoria classica di adversarial example proprio perché non produce un errore, ma un costo ed è per questo che solo una lettura congiunta del report tecnico del CERT-AgID, dei principi delle bozze di linee guida AgID, dell’articolo 15 AI Act e della metrica LCOAI riesce a renderlo visibile e governabile in sede di procurement.
Fonti e riferimenti essenziali
- AgID – Agenzia per l’Italia Digitale (2026). Bozza di Linee guida per il procurement di sistemi di Intelligenza Artificiale nella Pubblica Amministrazione. Bozza in consultazione pubblica dal 12 marzo 2026, fino all’11 aprile 2026 (Determinazione n. 43/2026).
- AgID – Agenzia per l’Italia Digitale (2026). Bozza di Linee guida per lo sviluppo di sistemi di Intelligenza Artificiale nella Pubblica Amministrazione. Bozza in consultazione pubblica dal 12 marzo 2026 fino all’11 aprile 2026 (Determinazione n. 43/2026). https://www.agid.gov.it/sites/agid/files/2026-03/LLGG_Sviluppo_per%20consultazione%20pubblica.pdf
- AgID – CERT-AgID (2026). Sicurezza e performance nel path MTP. Quando accelerare un LLM diventa anche un problema di affidabilità. Giugno 2026. Sicurezza e performance nel path MTP.pdf
- Curcio, E. (2025). Introducing LCOAI: A Standardized Economic Metric for Evaluating AI Deployment Costs. arXiv:2509.02596 (pubblicato il 29 agosto 2025). https://arxiv.org/abs/2509.02596
- DeepSeek-AI (2024). DeepSeek-V3 Technical Report. arXiv:2412.19437. https://arxiv.org/pdf/2412.19437 Testo originale della sezione 2.2: “Multi-Token Prediction Inspired by Gloeckle et al. (2024), we investigate and set a Multi-Token Prediction (MTP) objective for DeepSeek-V3, which extends the prediction scope to multiple future tokens at each position. On the one hand, an MTP objective densifies the training signals and may improve data efficiency. On the other hand, MTP may enable the model to pre-plan its representations for better prediction of future tokens. Figure 3 illustrates our implementation of MTP. Different from Gloeckle et al. (2024), which parallelly predicts 𝐷 additional tokens using independent output heads, we sequentially predict additional tokens and keep the complete causal chain at each prediction depth. We introduce the details of our MTP implementation in this section.”
- Gloeckle, F., Youbi Idrissi, B., Rozière, B., Lopez-Paz, D., & Synnaeve, G. (2024). Better & Faster Large Language Models via Multi-Token Prediction. Proceedings of the 41st International Conference on Machine Learning (ICML), PMLR 235, 15706–15734 (pubblicato il 30 aprile 2024 su arXiv). https://arxiv.org/abs/2404.19737
Di Beatrice Meloni Studentessa in Giurisprudenza presso l’Università degli Studi di Cagliari.